
Se você já colocou um modelo de IA para resolver uma tarefa técnica do início ao fim, provavelmente viveu a mesma frustração: nas três primeiras respostas ele parece um gênio; na quinta, esquece o que combinou no início; na décima, inventa um parâmetro que não existe e derruba tudo.
A culpa disso não é do modelo. É de quem colocou um motor potente na pista sem chassi, sem freios e sem instrumentos de bordo. No desenvolvimento sério de agentes, chamamos essa estrutura ao redor do modelo de Harness (o chassi operacional).
Dois dos melhores textos que já li sobre o assunto mostram isso por ângulos complementares:
- Martin Fowler e Birgitta Böckeler (Thoughtworks): Analisaram o harness com a disciplina da engenharia de software clássica, trazendo conceitos de cibernética, controles antes da ação (feedforward) e sensores depois da ação (feedback).
- LangChain (Vivek Trivedy): Detalhou o lado prático de sistemas operacionais: salvar memória em disco, rodar scripts em sandbox, evitar que o modelo se perca com históricos longos e manter loops de execução funcionando.
Neste guia, reuni o melhor dessas duas visões em um passo a passo direto, sem complicação e com foco no que realmente funciona na prática.
1. A Equação Fundamental: Agente = Modelo + Harness
Antes de sair testando ferramentas, vale deixar clara uma verdade que o marketing de IA costuma ignorar:
Agente de IA = Modelo (Inteligência Estatística) + Harness (Engenharia de Sistemas)Um modelo de linguagem puro nada mais é do que uma função estatística. Ele recebe um bloco de texto e prevê as próximas palavras mais prováveis. Sozinho, ele não guarda memória depois que a sessão encerra, não cria arquivos no seu computador, não roda comandos no terminal e não tem como saber se o código que acabou de gerar compila ou quebra no primeiro teste.
Se não é responsabilidade do modelo, é trabalho do harness.
O harness é todo o conjunto de código, validações, limites e ferramentas que protegem e direcionam o modelo para que ele execute tarefas reais com segurança.
flowchart TD
    classDef llm fill:#eff6ff,stroke:#3b82f6,stroke-width:2px,color:#1e3a8a;
    classDef harness fill:#f0fdf4,stroke:#16a34a,stroke-width:2px,color:#14532d;
    classDef prod fill:#fefce8,stroke:#ca8a04,stroke-width:2px,color:#713f12;

    subgraph MODELO["1. O Modelo de Linguagem (LLM)"]
        direction TB
        M1["Recebe contexto<br/>de entrada"]:::llm --> M2["Calcula distribuição<br/>estatística"]:::llm
        M2 --> M3["Gera proposta de texto<br/>ou código"]:::llm
    end

    subgraph HARNESS["2. O Harness (Estrutura Operacional)"]
        direction TB
        H1["Arquivos & Git<br/>(Memória Durável)"]:::harness
        H2["Sandbox & Bash<br/>(Execução Segura)"]:::harness
        H3["Linters & Testes<br/>(Sensores na CPU)"]:::harness
        H4["Compaction de Histórico<br/>(Anti-Degradação)"]:::harness
    end

    MODELO <--> HARNESS
    HARNESS --> OUT["Software Confiável<br/>em Produção"]:::prod
2. A Visão de Martin Fowler: Controles Antes e Depois da Ação
Na análise feita para a Thoughtworks, Birgitta Böckeler e Martin Fowler comparam o harness a um regulador cibernético, ou seja, um sistema que mantém o agente no rumo certo atuando em duas frentes:
A. Guias de Orientação Prévia (Feedforward Controls)
São os direcionamentos e limites que você entrega antes de o modelo começar a gerar qualquer resposta. O objetivo aqui é elevar as chances de ele acertar logo na primeira tentativa.
- Exemplos práticos: Arquivos como
AGENTS.md, regras claras de arquitetura, contratos de dados bem tipados, padrões de nomenclatura e referências técnicas sob medida.
B. Sensores de Correção Posterior (Feedback Controls)
São as esteiras que rodam depois que o modelo gera o código ou a resposta. Elas pegam os erros no pulo e devolvem o feedback para que o próprio agente se corrija antes de incomodar você.
- Exemplos práticos: Linters de sintaxe, baterias de testes unitários, verificadores de tipo (como TypeScript e MyPy) e scripts de validação de estrutura.
Controles Computacionais vs. Controles Inferenciais
Aqui está uma das sacadas mais valiosas de Martin Fowler: nunca gaste IA para validar aquilo que um script simples resolve em milissegundos.
| Tipo de Controle | Quem Executa? | Custo & Tempo | Confiabilidade | Exemplos |
|---|---|---|---|---|
| Computacional | CPU (Scripts, Compiladores) | Milissegundos / Centavos | 100% Determinístico | pytest, eslint, git diff, regex de validação |
| Inferencial | GPU / LLM (Outro modelo) | Segundos / Custo maior | Probabilístico | Avaliação de tom, clareza editorial, semântica |
Se você pede para um modelo de linguagem conferir se uma chave JSON existe ou se uma aspa foi fechada, você está gastando dinheiro à toa e trazendo incerteza para onde a matemática já tem resposta exata. Deixe a CPU cuidar do que é determinístico e use a IA apenas onde realmente existe julgamento semântico.
3. A Visão da LangChain: Os 4 Pilares da Anatomia de um Harness
Enquanto Martin Fowler desenhou a governança do processo, o time da LangChain mapeou a infraestrutura necessária para colocar isso de pé. Na prática, um harness bem montado resolve quatro limitações nativas dos modelos:
flowchart TD
    classDef defNode fill:#fef2f2,stroke:#ef4444,stroke-width:2px,color:#991b1b;
    classDef solNode fill:#eff6ff,stroke:#2563eb,stroke-width:2px,color:#1e40af;

    subgraph DEF["Limitações Nativas do Modelo"]
        direction TB
        D1["1. Sem memória durável pós-sessão"]:::defNode
        D2["2. Incapacidade de testar o próprio código"]:::defNode
        D3["3. Context Rot (Cansaço com histórico longo)"]:::defNode
        D4["4. Abandono precoce em tarefas complexas"]:::defNode
    end

    subgraph SOL["Soluções do Harness Operacional"]
        direction TB
        S1["Sistema de Arquivos & Git como Memória"]:::solNode
        S2["Sandbox Isolada com Terminal Bash"]:::solNode
        S3["Compaction & Progressive Disclosure"]:::solNode
        S4["Loops de Planejamento e Autocorreção"]:::solNode
    end

    D1 ==>|"Resolve com"| S1
    D2 ==>|"Resolve com"| S2
    D3 ==>|"Resolve com"| S3
    D4 ==>|"Resolve com"| S4
1. O Sistema de Arquivos como Memória Durável
Modelos perdem o contexto assim que o comando termina. O harness contorna isso usando o sistema de arquivos local (arquivos .md, .json, .yaml) como a mesa de trabalho oficial do agente.
A conversa no chat é passageira, mas o que está no disco permanece. Com o Git integrado a essa esteira, o agente pode abrir ramificações para experimentar e reverter falhas sem risco.
2. Terminal e Execução de Código (em vez de dezenas de ferramentas rígidas)
Em vez de criar uma ferramenta engessada para cada ação possível, o harness moderno coloca um terminal em ambiente seguro nas mãos do agente. Com isso, ele mesmo cria pequenos scripts em Python ou Shell para inspecionar pastas, compilar arquivos e checar resultados de maneira independente.
3. Combate ao Desgaste de Contexto (Context Rot)
Quando uma sessão se estende por milhares de tokens, o modelo começa a perder a atenção e a coerência. Na literatura técnica, isso é chamado de Lost in the Middle ou Context Rot. O harness resolve isso com duas práticas:
- Compactação (Compaction): Sintetizar partes antigas da conversa e salvar o histórico relevante no disco, mantendo a memória de trabalho sempre enxuta.
- Carregamento sob Demanda (Progressive Disclosure): Em vez de jogar centenas de páginas de regras logo no início, entregar apenas os índices essenciais e carregar detalhes somente quando forem necessários.
4. Loops Autônomos de Autocorreção
Em trabalhos mais longos, é comum o modelo parar na metade ou achar que terminou antes de rodar qualquer teste. O harness assume o controle: roda as checagens na CPU e, se encontrar algum problema, devolve a mensagem de erro detalhada para que o próprio modelo conserte o que fez.
4. O Loop de Pilotagem: Como o Sistema se Auto-Corrige
Quando juntamos a visão de Martin Fowler com as práticas da LangChain, o ciclo de trabalho de um agente robusto se parece com uma linha de produção contínua:
sequenceDiagram
    autonumber
    actor Humano as Humano (Arquiteto)
    participant Harness as Harness (Controlador)
    participant LLM as Modelo (Raciocínio)
    participant CPU as Sensores (CPU)

    Humano->>Harness: 1. Define objetivo e regras
    Harness->>LLM: 2. Injeta guias e contexto inicial
    LLM->>Harness: 3. Gera proposta de código
    Harness->>CPU: 4. Roda linters e testes na CPU

    rect rgb(254, 242, 242)
        Note over Harness,LLM: Se houver falha de compilação ou teste
        CPU-->>Harness: Erro detectado (Código != 0)
        Harness->>LLM: Reinjeta erro para autocorreção
        LLM->>Harness: Emite código corrigido
    end

    rect rgb(240, 253, 244)
        Note over Harness,Humano: Quando aprovado nos testes
        CPU-->>Harness: Validação 100% aprovada
        Harness-->>Humano: Entrega artefato final pronto
    end
Como interpretar este ciclo na prática:
- Passo 1 (O Humano comanda): Você não gasta energia digitando prompts soltos no chat. Seu papel é definir o objetivo da tarefa, as restrições de arquitetura e quais testes determinísticos precisam passar.
- Passo 2 (O Harness orienta): Antes de o modelo gerar uma única linha, o harness injeta o contexto enxuto, os contratos de entrada e as regras de governança (feedforward).
- Passo 3 (O Modelo propõe): A IA atua onde é insubstituível: processar o contexto e gerar a primeira versão do código ou do arquivo.
- Passo 4 (A CPU fiscaliza): O harness intercepta essa proposta e executa os sensores determinísticos (linters, checadores de tipo e testes unitários rodando em CPU local).
- O Loop de Autocorreção (Faixa Vermelha): Se houver falha de sintaxe ou teste quebrado, o log de erro do terminal é reinjetado no modelo. Ele recebe exatamente o que quebrou e ajusta o código sozinho, sem você precisar intervir.
- A Entrega Aprovada (Faixa Verde): Somente quando a CPU devolve código de saída zero (100% verificado) o harness finaliza o ciclo e entrega o artefato com evidências de teste.
5. Mapa Mental: Visão Panorâmica da Arquitetura de Harness
Uma síntese visual que reúne as lições de Martin Fowler, a engenharia prática da LangChain e o papel do profissional de tecnologia.
Para amarrar todos esses pontos e deixar uma referência fácil de consultar no seu dia a dia, estruturei o mapa mental abaixo com a divisão exata de responsabilidades:
- O Núcleo Estatístico (LLM): O motor de raciocínio, mantido focado apenas em processar contexto e propor soluções, sem acesso solto e desprotegido ao seu ambiente.
- O Eixo Feedforward (Martin Fowler): Tudo o que entra antes do comando para guiar o modelo, como arquivos de regras (
AGENTS.md), contratos tipados e documentações consultadas sob demanda. - O Eixo Feedback (Martin Fowler): Sensores rápidos e exatos na CPU (linters, checagens de tipos e testes automatizados) que barram falhas e abastecem o loop de correção.
- As Primitivas de Sistema (LangChain): Arquivos salvos em disco para reter memória, terminal em sandbox para rodar tarefas e controle rigoroso da janela de contexto.
- O Papel do Humano: Sair da posição de digitador de prompts para atuar como o arquiteto do fluxo, ajustando os testes, definindo os limites e aprovando entregas.
Abaixo você encontra o mapa mental completo para estudar e usar nos seus projetos:
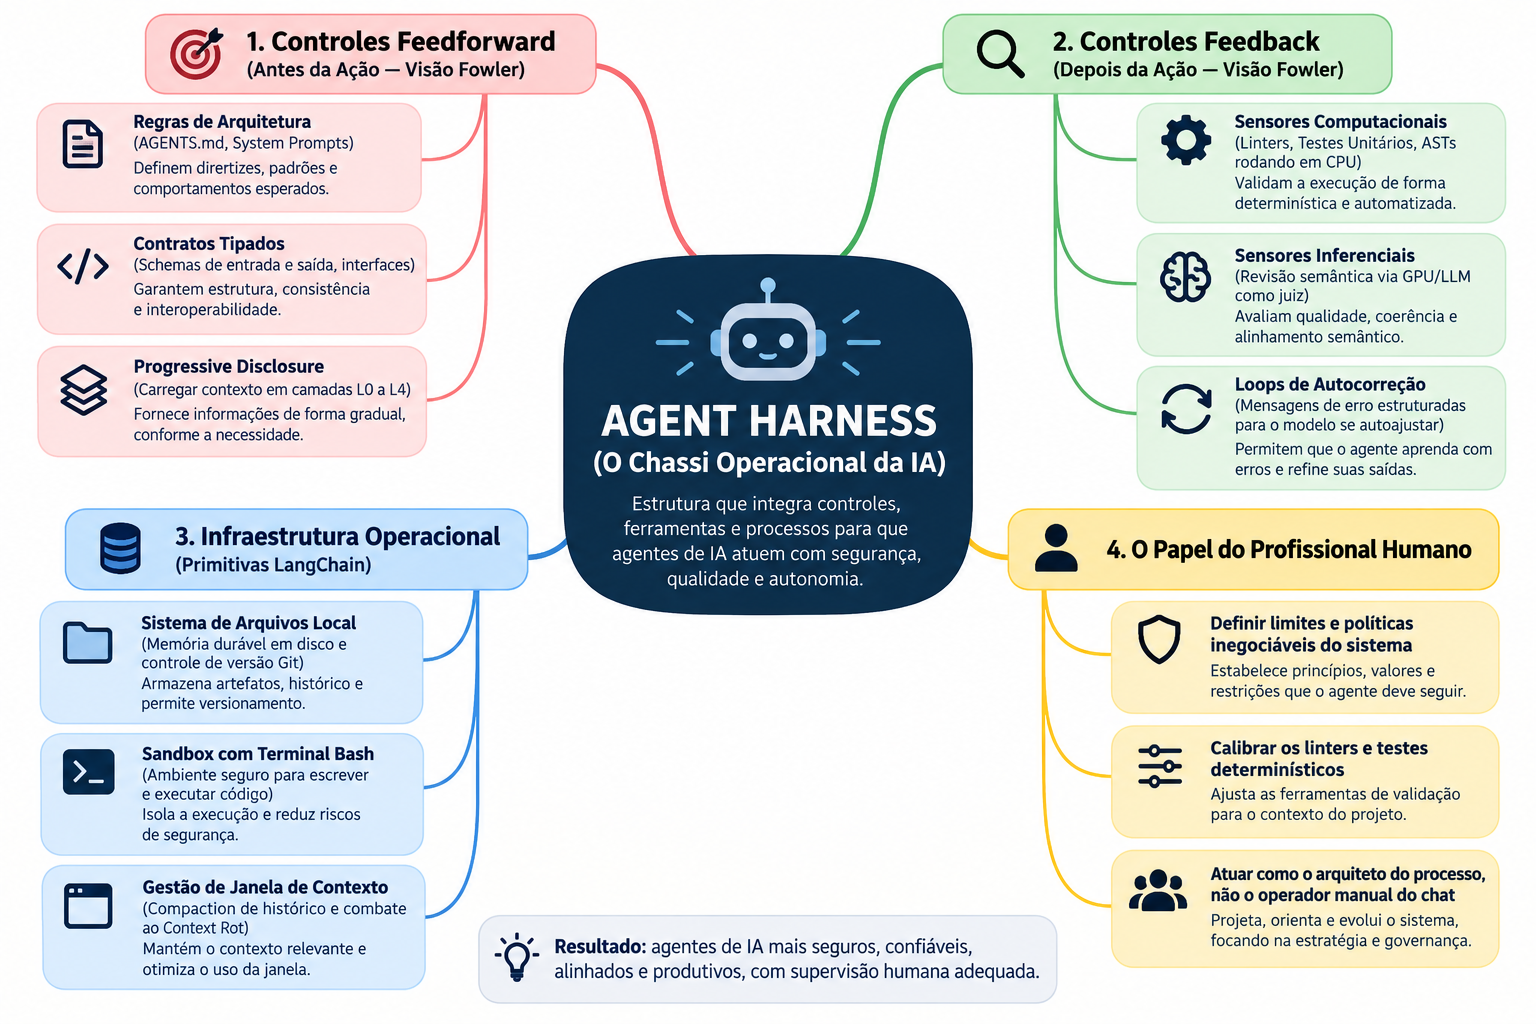
Quando for desenhar um novo agente ou squad de IA, use este mapa mental como um checklist de bancada: se o seu sistema não tiver persistência em arquivos, testes automáticos na CPU e regras claras de orientação prévia, você ainda está operando um chat informal, não um sistema profissional.
Conclusão e Próximos Passos
A diferença entre passar o dia brigando com respostas truncadas no chat e colocar uma esteira de agentes para entregar resultados consistentes se resume a uma palavra: harness.
No instante em que você para de tratar a inteligência artificial como um oráculo infalível e passa a encará-la como um componente de software (que exige limites, tipos bem amarrados e testes automatizados), a qualidade das suas entregas sobe de patamar.
Para quem tem quilometragem em bancos de dados relacionais e ambientes corporativos (como foi minha rotina durante anos lidando com Oracle e SAP), isso soa como algo natural: ninguém em sã consciência aceita dados soltos sem constraints, chaves primárias e regras de integridade. Com modelos de IA, a necessidade de blindagem é rigorosamente a mesma.
Se você quer avançar nessa direção e aplicar engenharia de software de verdade na automação com IA, acompanhe nossos conteúdos e cursos práticos aqui no ecossistema Mayko IA.